A P&D automotiva europeia está em ritmo acelerado: programas de eletrificação, veículos definidos por software, validação de ADAS/AV e gêmeos digitais de fábrica impulsionam cargas de trabalho de simulação e IA para clusters maiores de GPU/CPU com ciclos de iteração mais curtos.
O limitador oculto não é mais a computação. É o tecido de rede—mover gradientes, conjuntos de dados de sensores, malhas e mensagens MPI rápido o suficiente para que as equipes não sejam travadas por latência de cauda, congestionamento ou desempenho imprevisível sob carga.
É aí que o Cornelis Networks CN5000 se encaixa: um interconector de ponta a ponta, projetado especificamente para tráfego sem perdas e sem congestionamento a 400G, com destaques de latência MPI de submicrossegundo e gerenciamento de congestionamento em nível de malha, construído na arquitetura Omni-Path.
E, combinado com as capacidades de distribuição e integração focadas na Europa da Hammer’s, torna-se um caminho prático para organizações automotivas implementarem e suportarem redes de alto desempenho em equipes de engenharia multi-site.
Por que a Inovação Automotiva Agora Depende da Rede
Os fluxos de trabalho de engenharia automotiva são cada vez mais acoplados e iterativos:
- Simulação de colisão e segurança (grandes jobs MPI, muitas mensagens pequenas, sensível à latência e à latência de cauda)
- CFD, análise aero e térmica (grandes decomposições de domínio com comunicação de todos para todos)
- Modelagem de baterias e eletrônica de potência (multifísica, grandes conjuntos)
- Treinamento de percepção ADAS e fusão de sensores (comunicação coletiva de IA distribuída)
- Gêmeos digitais de veículos e fábricas (alimentação contínua de dados, testes rápidos de cenários)
À medida que os clusters escalam, “boa largura de banda média” não é mais suficiente.. As equipes automotivas precisam de:
- Desempenho previsível sob carga
- Baixa latência de cauda (para que o rank/trabalhador mais lento não domine o tempo de etapa)
- Gerenciamento de congestionamento que se sustenta em condições reais de uso misto—não apenas em padrões de tráfego de melhor caso
O CN5000 em um minuto
O CN5000 é posicionado como uma rede de expansão (scale-out) sem perdas e sem congestionamento para IA e HPC, projetada para manter o desempenho estável à medida que você cresce.
De relance:
- Largura de banda de 400G por porta
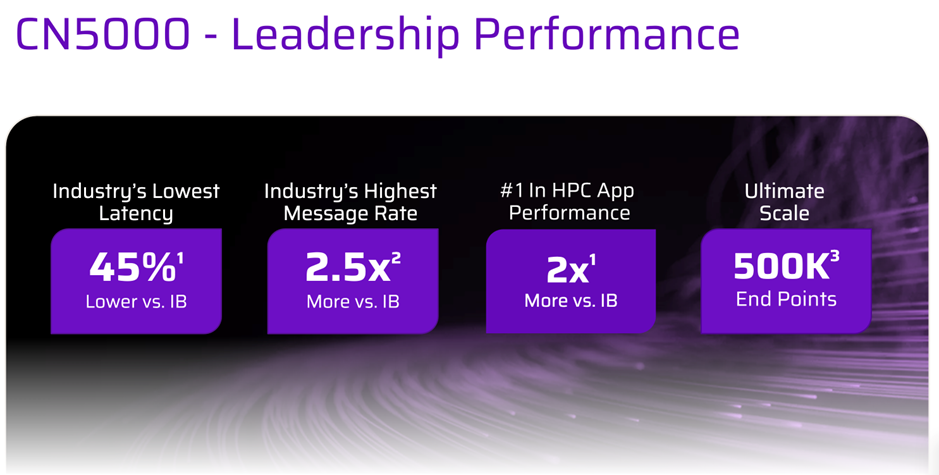
- < 1 µs de latência MPI (destaques do Switch e SuperNIC)
- Os blocos de construção arquitetônicos incluem:
- Controle de fluxo baseado em crédito
- Retransmissões em nível de link
- Gerenciamento de congestionamento no nível da malha (fabric)
Encaminhamento multipercursoO Encaminhamento Adaptativo de Granularidade Fina (FGAR) e o controlo de fluxo sensível a incast são destacados como parte da abordagem de gestão de congestionamento
Com mais de 240 engenheiros e tecnólogos dedicados a avançar a inovação em redes, a Cornelis e a Hammer estão focadas em desbloquear maior eficiência de data center. Nosso portfólio completo de SuperNICs e switches baseia-se no nosso legado como inventores do Omni-Path, uma arquitetura projetada para entregar redes de mais alto desempenho na era de expansão horizontal e um conjunto de recursos fundamental para o Ultra Ethernet. Trazemos desempenho líder do setor, incluindo latência ultrabaixa, altas taxas de mensagens e desempenho otimizado de aplicações.
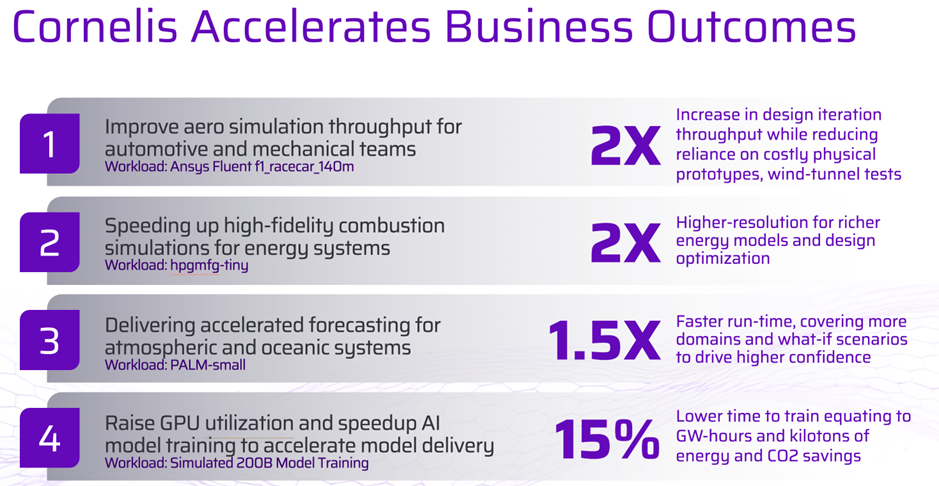
Exemplo de impacto para o cliente:
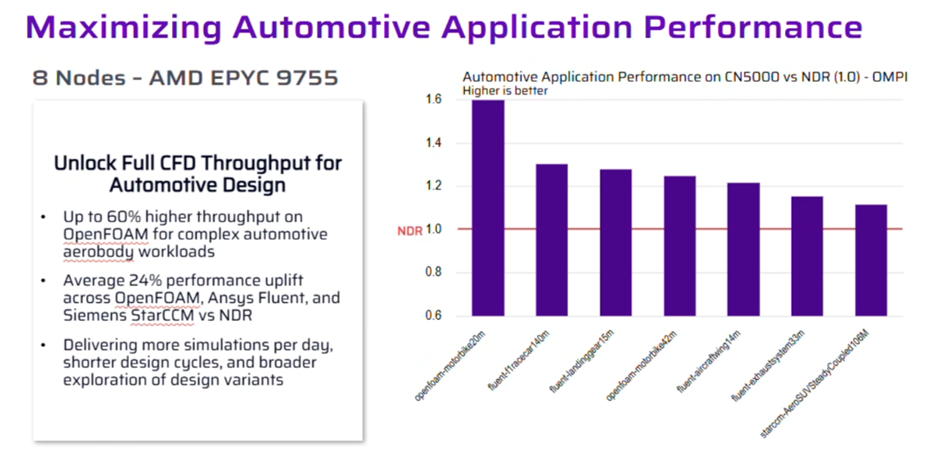
Melhor throughput em simulações aerodinâmicas para equipes automotivas e mecânicas, proporcionando até um aumento de 2× no throughput de iteração de design, ao mesmo tempo que reduz a dependência de protótipos físicos caros e testes em túnel de vento.
-
- CN5000 Switch:
- 48 portas de 400G
- CN5000 Switch:
CN5000 vs InfiniBand vs RoCEv2 Ethernet (Comparação focada em automotivo)
|
O que você está comparando |
Cornelis Networks CN5000 (Omni-Path) |
InfiniBand NDR 400 (por exemplo, Quantum-2) |
Ethernet 400G com RoCEv2 |
|
Intenção principal |
Fabric de scale-out projetado especificamente para IA + HPC com foco em design sem perdas e livre de congestionamento. |
Malha HPC/AI com roteamento adaptativo e controle de congestionamento como parte do valor da plataforma. |
Ethernet de padrão aberto adaptado para IA/HPC de baixa latência usando técnicas “sem perdas” (frequentemente PFC + ECN + controle de congestionamento de ponta a ponta, como DCQCN). |
|
Classe de velocidade do link |
400G por porta (opções de Switch e SuperNIC). |
400Gb/s por porta (NDR 400). |
Comumente Ethernet 400G; RoCEv2 usado para RDMA (dependente do design/fornecedor). |
|
Densidade de portas de switch 1U (exemplo) |
48 × 400G Switch; 38.4T full duplex. |
Frequentemente 64 × 400Gb/s em 1U (depende do modelo). |
Varia amplamente; o comportamento depende fortemente do ASIC/fornecedor e das suas escolhas de QoS/ buffer/ECMP/telemetria e ajuste. |
|
Abordagem de congestionamento / sem perdas (alto nível) |
Credit-based flow control, link-level retransmissions, fabric-level congestion management, multipath routing—aimed at predictable performance and reduced tail latency. |
Controle de congestionamento em nível de plataforma, QoS/lanes virtuais, roteamento adaptativo; pode incluir recursos de aceleração na rede (específicos da plataforma). |
“Ethernet sem perdas” normalmente usa PFC para evitar quedas, além de ECN para marcar congestionamento e sinalizar redução de taxa; o sucesso operacional depende da disciplina de configuração. |
|
Atenções operacionais |
Trate como um sistema de ponta a ponta (Switch + SuperNIC + software) para alinhar com a arquitetura pretendida. |
Escolha forte onde o ecossistema/ferramentas IB e fluxos de trabalho existentes estão consolidados. |
Os resultados do RoCEv2 dependem fortemente do design correto de PFC/ECN e da disciplina operacional contínua; configurações incorretas podem criar comportamento severo de congestionamento/latência. |
O que “Sem Perdas, Livre de Congestionamento” Significa em Resultados de Engenharia do Dia a Dia
Rotatividade mais rápida do solver -
Em grandes simulações MPI, o tempo de execução pode ser dominado por fases de comunicação (troca de halo, reduções, sincronização). O CN5000 enfatiza a otimização da taxa de mensagens e da latência, juntamente com o gerenciamento de congestionamento—visando desempenho previsível sob carga.
Melhor eficiência de treino de IA distribuída (pilhas de ADAS/AV e autonomia)
O CN5000 se posiciona como uma estrutura projetada para treinamento e inferência de IA que mantém a taxa de transferência sob carga, minimizando eventos de congestionamento e latência de cauda.
Onde você sentirá isso: maior utilização de GPU (menos tempo esperando por coletivos), tempos de etapa mais estáveis, melhor tempo de treinamento para novos domínios de sensores ou variantes de modelo.
Controle prático por meio de telemetria (não adivinhação)
Quando várias equipes compartilham a mesma plataforma, os padrões de tráfego podem mudar a cada hora. O CN5000 destaca a telemetria e a visibilidade em tempo real para apoiar o gerenciamento de tráfego consciente da carga de trabalho.
Onde você vai sentir isso: causa-raiz mais rápida para variação de desempenho e planejamento de capacidade mais claro, especialmente em clusters de uso misto.
Projetando o CN5000 em clusters reais de HPC e IA automotivos
Trate o congestionamento como o caso normal, não como um caso extremo
As plataformas automotivas são quase sempre de uso misto: CAE pela manhã, treinamento à tarde, pipelines de gêmeos digitais em segundo plano, e todos empurrando “mais uma execução” antes de um marco. O CN5000 destaca o gerenciamento de congestionamento em nível de malha, controle de fluxo consciente de incast e roteamento adaptativo para sustentar o desempenho sob carga.
Mantenha sua história de “sem perdas” de ponta a ponta
A Cornelis enquadra a “transmissão sem perdas e sem congestionamento” como uma propriedade arquitetónica do CN5000 (Switch + SuperNIC + controlo de encaminhamento/fluxo). Na prática: especifique-o como um sistema, valide-o como um sistema.
Quer saber mais?