A manufatura inteligente na Europa foi muito além de CLPs mais painéis de controle. Hoje, ela inclui inspeção por visão computacional, otimização orientada por IA, gêmeos digitais que exigem fidelidade em tempo real e clusters de borda que devem se comportar como mini data centers - de forma confiável, todos os dias.
Nessa realidade, a dor de escalonamento mais comum muitas vezes não é o modelo ou a GPU. É a rede: congestionamento, jitter e perda de pacotes aparecendo exatamente quando você adiciona a próxima linha, o próximo conjunto de câmeras ou o próximo pipeline de análise.
É aí que uma capacidade muito específica se torna central: Cornelis CN5000 Omni-Path® , posicionado pela Cornelis como “a primeira rede de escala horizontal sem perdas e sem congestionamento do mundo” - em parceria com a Hammer Distribution para tornar o design, o fornecimento e a implementação liderada por parceiros viáveis em toda a Europa.[RM1]
Por que a IA de fábrica estressa as redes de forma diferente
Os padrões de dados industriais podem ser um pouco… rudes. Você frequentemente vê:
- Fluxos de visão de alta taxa alimentando nós de inferência e armazenamento simultaneamente
- Momentos “incast” em rajadas quando muitos dispositivos relatam juntos (alarmes, eventos em lote, estatísticas de fim de ciclo)
- Tráfego leste-oeste entre nós para análise, extração de características e simulação
- Uma mistura de fluxos quase em tempo real (controle de inspeção, coordenação robótica) junto com tráfego menos crítico
Em redes de melhor esforço, microexplosões e pressão de fila podem levar a descartes de pacotes e retransmissões - um caminho comum para picos de latência de cauda. (É por isso que os designs de “Ethernet sem perdas” para RDMA normalmente dependem de mecanismos como PFC e ECN/DCQCN, com ajuste cuidadoso ao longo do caminho.)
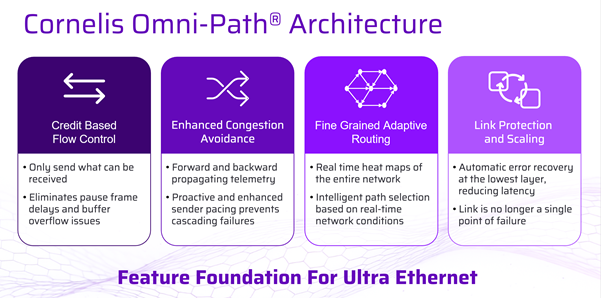
A malha de expansão sem perdas e sem congestionamento do CN5000
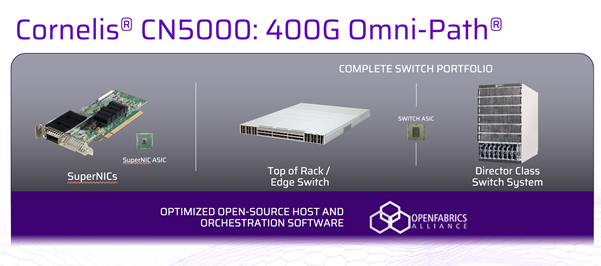
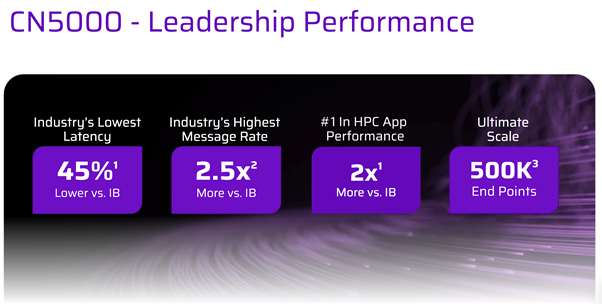
A Cornelis descreve o CN5000 como fornecendo transmissão de dados sem perdas e livre de congestionamento usando controle de fluxo baseado em crédito e roteamento adaptativo dinâmico de granulação fina, projetado para manter a taxa de transferência e a latência previsíveis à medida que as cargas aumentam.
Uma forma útil de enquadrar isso para fabricantes:
O CN5000 não está tentando “lidar” com o congestionamento depois do fato - ele é projetado para prevenir perdas e gerenciar o congestionamento de forma comportamental em toda a malha.
Os materiais do Cornelis’ CN5000 Director Class Switch também destacam telemetria de granularidade fina e análise de tráfego em tempo real para detectar congestionamento e otimizar o desempenho, além de pontos de escala de alta densidade, como até 576 portas de 400G na plataforma da classe director.
Comparação: CN5000 Omni-Path vs abordagens comuns de malha para clusters de IA/edge de fábrica
|
O que você se importa na manufatura inteligente |
Cornelis CN5000 Omni-Path |
RoCEv2 em Ethernet (design Ethernet sem perdas) |
InfiniBand (implantações típicas) |
|
Objetivo principal do design |
Rede de escala horizontal sem perdas e sem congestionamento para padrões de tráfego estilo IA/HPC |
RDMA sobre Ethernet, tipicamente projetado para se comportar sem perdas para classes RDMA |
Comportamento de malha sem perdas com controle de fluxo baseado em crédito (implantações comuns) |
|
Como a ausência de perdas é abordada |
Controle de fluxo baseado em crédito + comportamento de congestionamento no nível da estrutura (descrição da Cornelis) |
Frequentemente via PFC + ECN/DCQCN (configuração e ajuste de ponta a ponta necessários) |
Controle de fluxo de link baseado em crédito para evitar perdas na malha (característica típica) |
|
Gerenciamento de congestionamento |
Encaminhamento adaptativo + comportamento de malha consciente de congestionamento (descrição Cornelis) |
Sinalização de congestionamento e ajuste de taxa no estilo ECN/DCQCN; PFC como rede de segurança |
Mecanismos de malha integrados e ferramentas operacionais maduras em muitos ambientes de HPC |
|
Ênfase operacional |
Eficiência de expansão horizontal + telemetria/análise de tráfego (Cornelis) |
Fortemente dependente de configuração consistente de PFC/ECN ao longo do caminho |
Frequentemente escolhido onde o comportamento determinístico do tecido é priorizado |
|
Por que isso importa na borda da fábrica |
Ajuda a manter a latência previsível quando visão + análise + simulação colidem no mesmo pod |
Pode funcionar bem, mas a engenharia de “Ethernet sem perdas” torna-se parte do escopo do projeto |
Uma opção conhecida para redes sem perdas e de baixa latência (mais típica em ambientes de HPC) |
O ponto não é “só existe uma resposta certa.” É que os clusters de borda de manufatura inteligente se comportam como ambientes de IA/HPC em escala reduzida, e o CN5000 é explicitamente posicionado para esses padrões de tráfego - sem perdas, com gerenciamento de congestionamento e observável em escala.
Onde a Hammer se encaixa ao transformar uma rede em uma solução europeia implantável
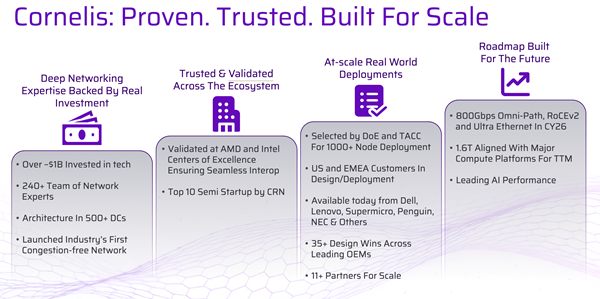
Os fabricantes raramente compram “uma estrutura” isoladamente. Eles compram um resultado entregue pelo parceiro: um design validado, montagens de rack integradas, logística que corresponde às janelas de implantação e suportabilidade que não entrará em colapso durante o primeiro incidente.
Então, num contexto Cornelis, o papel da Hammer é o pragmático: ajudar o canal a entregar o CN5000 de uma forma que corresponda à forma como a indústria transformadora europeia tende a implementar projetos - pod piloto → primeira linha → primeiro site → repetibilidade multi-site.
Casos de uso que se mapeiam perfeitamente ao conjunto de recursos do CN5000
1) Pods de inspeção de visão que não toleram oscilação de desempenho
A inspeção de alta resolução cria throughput sustentado além de rajadas (metadados, gravações de armazenamento, gatilhos de eventos). O comportamento sem perdas e gerenciado por congestionamento ajuda a reduzir o efeito “estava tudo bem até adicionarmos mais duas câmeras”.
2) Loops de gêmeos digitais que precisam de fidelidade ao vivo
Um gêmeo alimentado tarde se torna uma ferramenta de relatório, não uma ferramenta operacional. O posicionamento do CN5000 em torno de transmissão sem congestionamento, além de telemetria/análise, é diretamente relevante quando você precisa de fluxos estáveis e observáveis na borda.
3) Análise de fábrica em escala - sem a fase de rede frágil
À medida que você escala de uma linha para muitas, a pressão de rajada e o comportamento estilo incast tornam-se mais comuns. Se a perda de pacotes começar a impulsionar retransmissões e latência de cauda, a estabilidade sofre. Uma malha projetada para permanecer sem perdas sob carga muda a história de escalabilidade.
Arquitetura de referência: um “pod de IA de fábrica” que escala
Um padrão simples e repetível que tende a funcionar bem é o pod de IA de fábrica: um cluster de borda autônomo que executa as partes em tempo real localmente, enquanto ainda integra upstream para treinamento e otimização em toda a frota.
Componentes principais
- 4–32 nós de GPU/CPU para inferência + análise
- Armazenamento local de alto desempenho (buffers de visão, recursos, retenção curta)
- Um tecido dedicado de escala horizontal para tráfego leste-oeste (onde vive a maior parte da dor)
- Secure north-south connectivity to the plant network and central services
Onde o CN5000 se posiciona:
- Como a malha leste-oeste entre computação e armazenamento para manter a latência previsível sob carga mista
- Fornecendo telemetria e análise de tráfego para detectar congestionamento e otimizar o desempenho antes que os operadores notem desvios
Onde a Hammer ajuda:
- Designs validados liderados pelo parceiro e integração de rack para que cada implantação de pod seja repetível entre sites
A grande vantagem: esta arquitetura escala operacionalmente. Depois de implantar o Pod v1 de forma limpa, você pode replicá-lo em outras plantas com muito menos incógnitas.
Operacionalizando o desempenho com telemetria (porque as fábricas não têm tempo para adivinhação)
Problemas de rede na manufatura raramente chegam educadamente. Eles chegam como:
- falhas intermitentes de inspeção
- atrasos de inferência inexplicáveis
- uma linha que “parece mais lenta” após uma atualização
- trabalhos de análise noturnos que repentinamente excedem a janela de manutenção
É por isso que a ênfase do CN5000 em telemetria de granularidade fina e análise de tráfego em tempo real é mais do que um recurso interessante - é um facilitador de operações. A Cornelis descreve explicitamente a telemetria/análise usada para detectar congestionamento e otimizar o desempenho em grandes contagens de endpoints.
Em termos práticos, a telemetria suporta:
- Isolamento mais rápido da causa raiz (computação, armazenamento ou rede?)
- Ajuste proativo (identifique links e padrões problemáticos antecipadamente)
- Escalonamento mais seguro (adicionar câmeras/nós com evidência, não esperança)
E como o Hammer suporta entrega e integração de parceiros, você pode incorporar essas expectativas operacionais na implantação desde o primeiro dia, em vez de adaptar a observabilidade após o primeiro susto de produção.
Conclusão: trate a rede como arquitetura de primeira classe
Se você está falando sério sobre acelerar a manufatura inteligente em toda a Europa, trate a rede como uma parte de primeira classe da arquitetura.
Cornelis CN5000 traz uma malha projetada e comercializada para desempenho de expansão sem perdas e sem congestionamento, com roteamento adaptativo e visibilidade profunda.
A Hammer ajuda a tornar essa capacidade implantável através do canal europeu - repetível, suportável e construída para o crescimento.
FAQ: Cornelis CN5000 na manufatura inteligente
Para que o Cornelis CN5000 é usado na manufatura inteligente?
CN5000 is used as the east–west interconnect inside a factory “AI pod”; the high-speed fabric between compute nodes (GPU/CPU), local storage, and analytics services. In smart manufacturing, that internal traffic is where vision streams, feature extraction, and simulation/analytics collide, and where congestion shows up first as you scale cameras, lines, and pipelines. The goal is predictable latency and throughput under load, not just high peak bandwidth.
Por que as cargas de trabalho de IA em fábricas causam congestionamento de rede e jitter?
Os dados de fábrica tendem a ser de alta taxa, intermitentes e sincronizados:
- Múltiplos feeds de visão podem atingir a inferência e o armazenamento ao mesmo tempo.
- “Incast” momentos acontecem quando muitos dispositivos reportam juntos (alarmes, eventos de fim de ciclo, conclusões em lote).
- Você obtém throughput sustentado além de microbursts, o que aumenta a pressão na fila.
Em redes de melhor esforço, isso geralmente se transforma em acúmulo de filas, descarte de pacotes e retransmissões, que é exatamente como os picos de latência de cauda aparecem, geralmente quando você adiciona “apenas mais uma” câmera, linha ou pipeline.
Como o CN5000 difere dos designs de “Ethernet sem perdas” como o RoCEv2?
Em muitos ambientes RoCEv2, o comportamento de “Ethernet sem perdas” é alcançado projetando o caminho Ethernet (comumente com PFC + ECN/DCQCN) e ajustando-o de ponta a ponta.
O CN5000 é tipicamente posicionado como adotando uma abordagem diferente: controle de fluxo baseado em crédito e tratamento de congestionamento no nível do tecido (além de roteamento adaptativo) para evitar que perdas e congestionamentos se acumulem.
A diferença prática é onde reside a complexidade operacional:
- RoCEv2: mais em disciplina de configuração/ajuste de Ethernet
- CN5000: mais em design de malha + política, com menos dependência de controles de “Ethernet sem perdas”
Quando um fabricante escolheria CN5000 Omni-Path vs InfiniBand?
Ambos visam um comportamento previsível e de baixa latência para computação escalável. A decisão geralmente se resume ao ecossistema e às operações:
- Escolha a opção que melhor se adapta à sua cadeia de ferramentas, habilidades, modelo de suporte e realidade de aquisição existentes.
- Use a “pod” lens: if your edge cluster behaves like a mini AI/HPC environment and you care most about stable scaling under mixed workloads, compare them on real collective-heavy and bursty factory patterns, not just clean lab benchmarks.
Como a telemetria e a análise de tráfego ajudam as operações na borda da fábrica?
Os problemas de rede de fábrica raramente se apresentam como alarmes organizados. Eles manifestam-se como:
- falhas intermitentes de inspeção
- atrasos de inferência inexplicáveis
- trabalhos de análise que excedem as janelas de manutenção
A telemetria de granularidade fina ajuda a responder rapidamente “computação, armazenamento ou rede?” e a identificar links sobrecarregados, padrões de congestionamento ou efeitos de vizinho ruidoso antes que os operadores sintam a degradação de desempenho. É isso que torna a escalabilidade mais segura; você adiciona câmeras/nós com evidências, não com suposições.
Qual o papel da Hammer Distribution na implantação do CN5000 na Europa?
O papel da Hammer é geralmente tornar a rede implantável e repetível, em vez de “apenas comprada”:
- designs validados mapeados para a carga de trabalho
- construções de rack integradas e pré-testes
- logística alinhada às janelas de implantação
- padrões de suporte para incidentes reais (operações do dia 2)
Na prática, isso suporta o caminho comum do fabricante: pod piloto → primeira linha → primeiro site → repetibilidade multi-site.
O que é uma “fábrica de pod de IA” e onde a rede se encaixa?
Um pod de IA de fábrica é um cluster de borda repetível que executa inferência e análise em tempo real localmente, enquanto integra upstream para treinamento e otimização de frota. Um padrão típico inclui:
- ~4–32 nós de GPU/CPU
- local high-performance storage
- um tecido dedicado leste–oeste
A maior parte da dor de escalabilidade vive nessa camada leste–oeste, então o tecido é a peça que você escolhe para manter a latência estável sob cargas mistas e em rajadas.
Quais casos de uso de manufatura inteligente se beneficiam mais de uma rede sem perdas e gerenciada por congestionamento?
Casos de uso que misturam throughput sustentado com rajadas e sincronização:
- Pods de inspeção de visão (fluxos + rajadas de metadados + gravações de armazenamento)
- Loops de gêmeo digital onde o atraso transforma “operações” em “relatórios”
- Análises escaladas em muitas linhas (padrões frequentes de incast e embaralhamento)
O tema comum: evitar a latência de cauda impulsionada por retransmissão que desestabiliza o desempenho em tempo real.
Quais são os sinais comuns de que a rede é o gargalo na IA de borda?
Sintomas que parecem “misteriosos” em produção:
- Falhas intermitentes de inspeção ou taxas de rejeição inconsistentes
- Tempo de inferência irregular (mesmo modelo, momentos de latência diferentes)
- A linha “parece mais lenta” após dimensionamento ou atualizações
- Trabalhos noturnos/em janelas de manutenção excedem subitamente a janela
Se o sistema estava estável e depois degrada após adicionar a próxima câmera/linha/pipeline, a malha é um suspeito frequente, especialmente quando o problema aparece apenas sob concorrência de pico.
Quer saber mais?